基础篇
这份指南写给所有想在 Ardot 上开发和使用 Skill 的朋友,无论你是设计师、产品、前端、AI 应用开发者,我们都感谢你与我们共建 Ardot 的 Skill 生态。
我们会在文章中详细介绍 Ardot 跟 Anthropic 标准的差异、能用哪些工具、写的时候需要留意什么。如果你在使用过程中遇到任何问题,或者有任何意见与建议,欢迎随时联系我们,我们会根据实际情况,不断地迭代本指南,以求更为清晰、准确。
Ardot Skill 沿用了 Anthropic Agent Skills 规范,你可以通过自定义 Skill 来扩展 AI 在 Ardot 上的能力。
本文目录:
一、5 分钟跑通第一个 Ardot Skill
二、Ardot 客户端运行时的关键行为
三、Ardot 上的 Skill 适配指南
四、容易踩的坑,以及对应的修改方案
Skill 的模板和完整示例请见下篇《模板与示例》。
一、5 分钟跑通第一个 Ardot Skill
1.1 Skill 是什么样子
一个 Skill 就是一个目录,里面至少要有一个 SKILL.md:
my-first-skill/
├── SKILL.md         # 必须有
├── references/      # 可选,按需引用的资料
├── assets/          # 可选,模板、配置等数据
└── scripts/         # 可选,可执行脚本(bash / python)
如果你之前没接触过 Skill,建议先花 10 分钟看看 Anthropic Skills 官方介绍。本指南会假设你对这些基础已经熟悉了。
1.2 最简 Skill 示例
我们从一个最简单的 Skill 开始,以它作为示例来说明 Skill 在 Ardot 上是如何被上传和调用的。
你可以直接 下载 hello-ardot skill,在 Ardot 中上传试跑,也可以根据以下步骤,一步步创建 hello-ardot skill,体验从零开始写 skill 的过程。
新建一个目录叫 hello-ardot,里面只放一个文件:hello-ardot/SKILL.md:
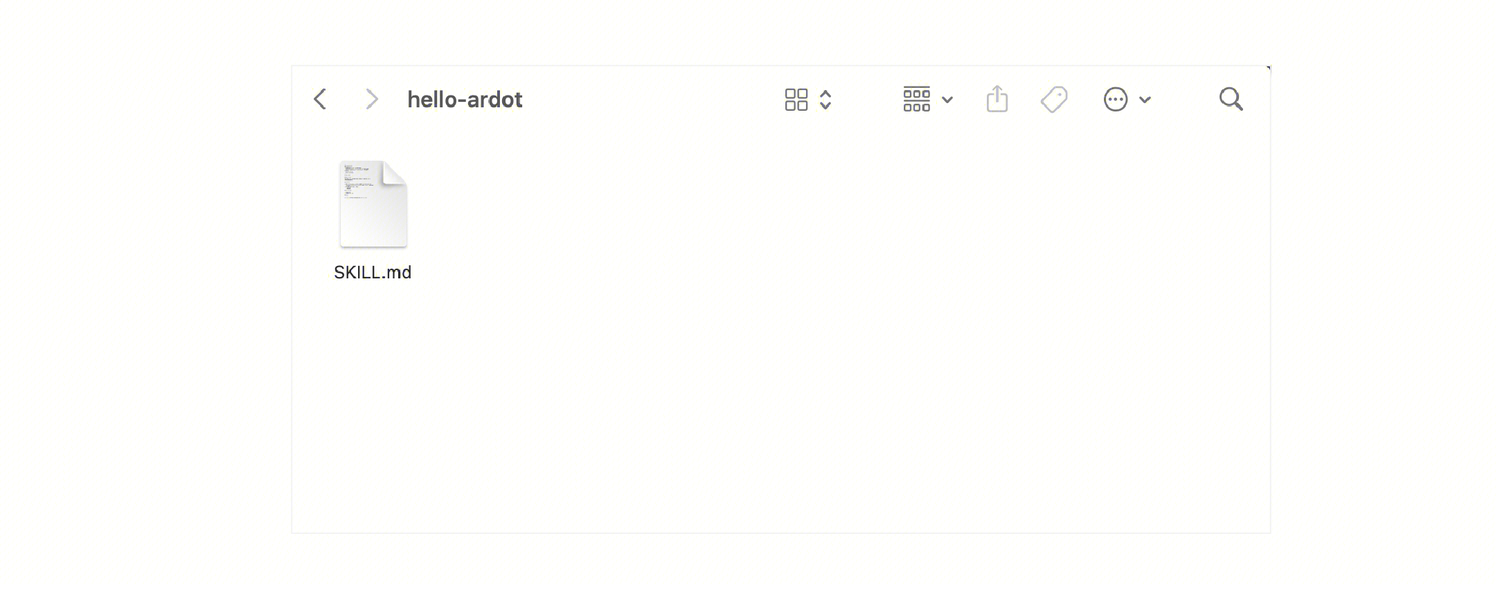
打开 SKILL.md 文件,把以下内容复制进去并保存:
---
name: hello-ardot
description: |
  打招呼并报告当前 Ardot 文件的基本信息。
  当用户说"你好 Ardot"、"hello ardot"、"打个招呼"时使用。
  Triggers: "你好 Ardot", "hello ardot", "打个招呼".
metadata:
  version: "0.1.0"
  author: your-name
---

# Hello Ardot

## When to use

当用户希望 AI 用一句话向他打招呼,并且报告一下当前打开的 Ardot
文件名和页面名时使用。

## Workflow

1. 调用 fetch_editor_state(建议把 `includeSchema` 和
   `includeGeneralEditInstructions` 都设为 `false`),获取当前
   文件和页面
2. 用一句中文向用户打招呼,并报告:
   - 当前文件名
   - 当前页面名

## Out of scope

- 不修改任何节点
- 不调用其他 MCP 工具

## Notes

这个 Skill 仅用于确认开发环境是否打通,是一个入门 demo。
1.3 上传和触发
完成上面这个 SKILL.md 之后:
把
hello-ardot/整个目录打包成 zip,并在 Ardot 客户端的 AI 小助手 - 技能管理处上传 Skill;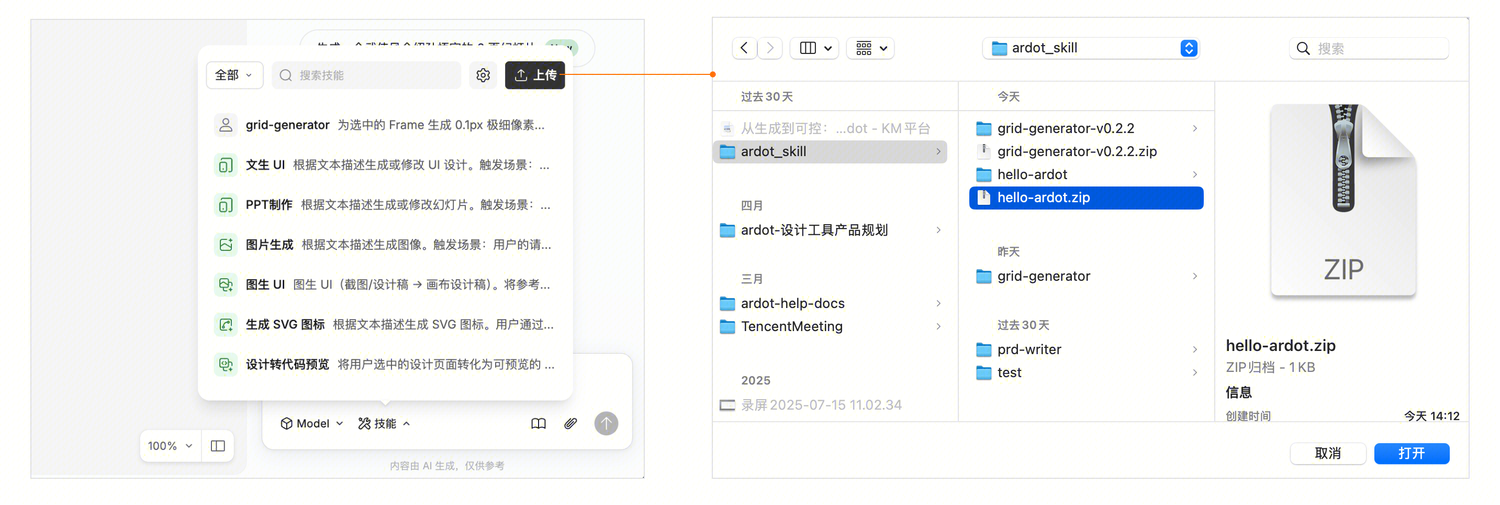
打开任意一个 Ardot 文件,在 AI 对话框里输入:
你好 Ardot
顺利的话,AI 会调用 fetch_editor_state,然后回你一句类似这样的话:
你好!你当前打开的文件是「你的 Ardot 上所打开的文件名」,当前页面是「当前文件下你所处在的 page 名」。
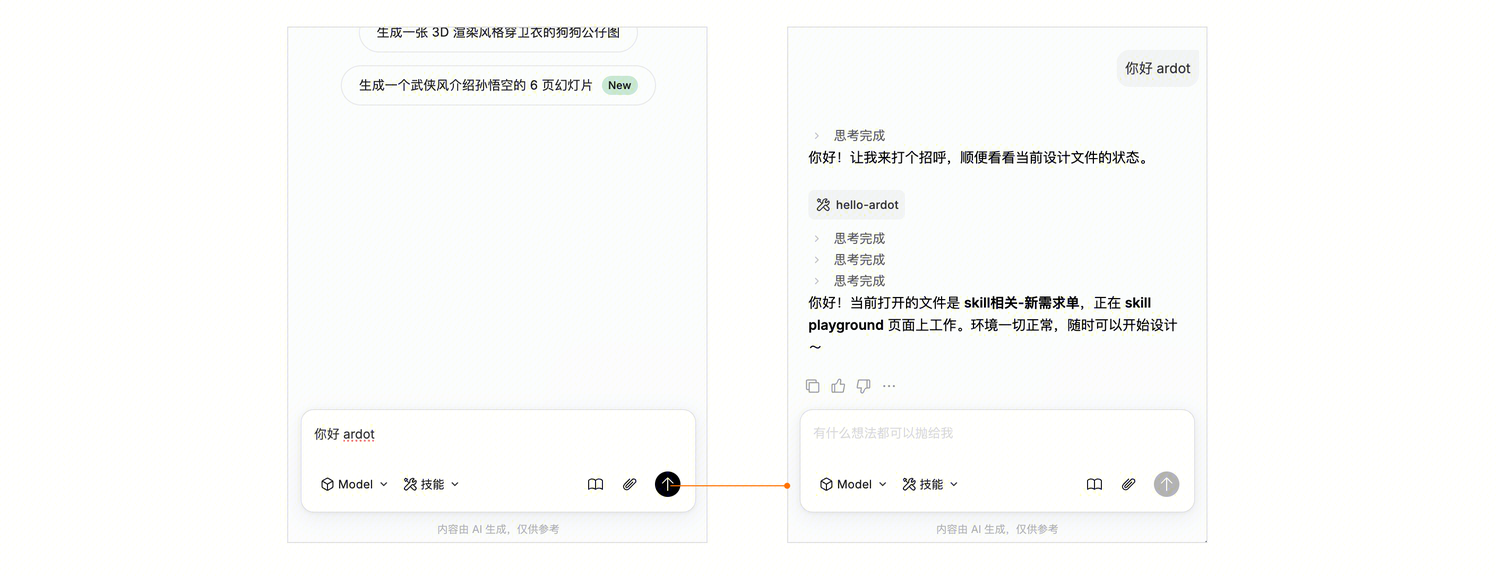
如果能跑通,说明你已经走完了一个完整的 Ardot Skill 闭环。接下来这一章会展开讲一下 Ardot 客户端运行时的细节。
1.4 Skill 管理
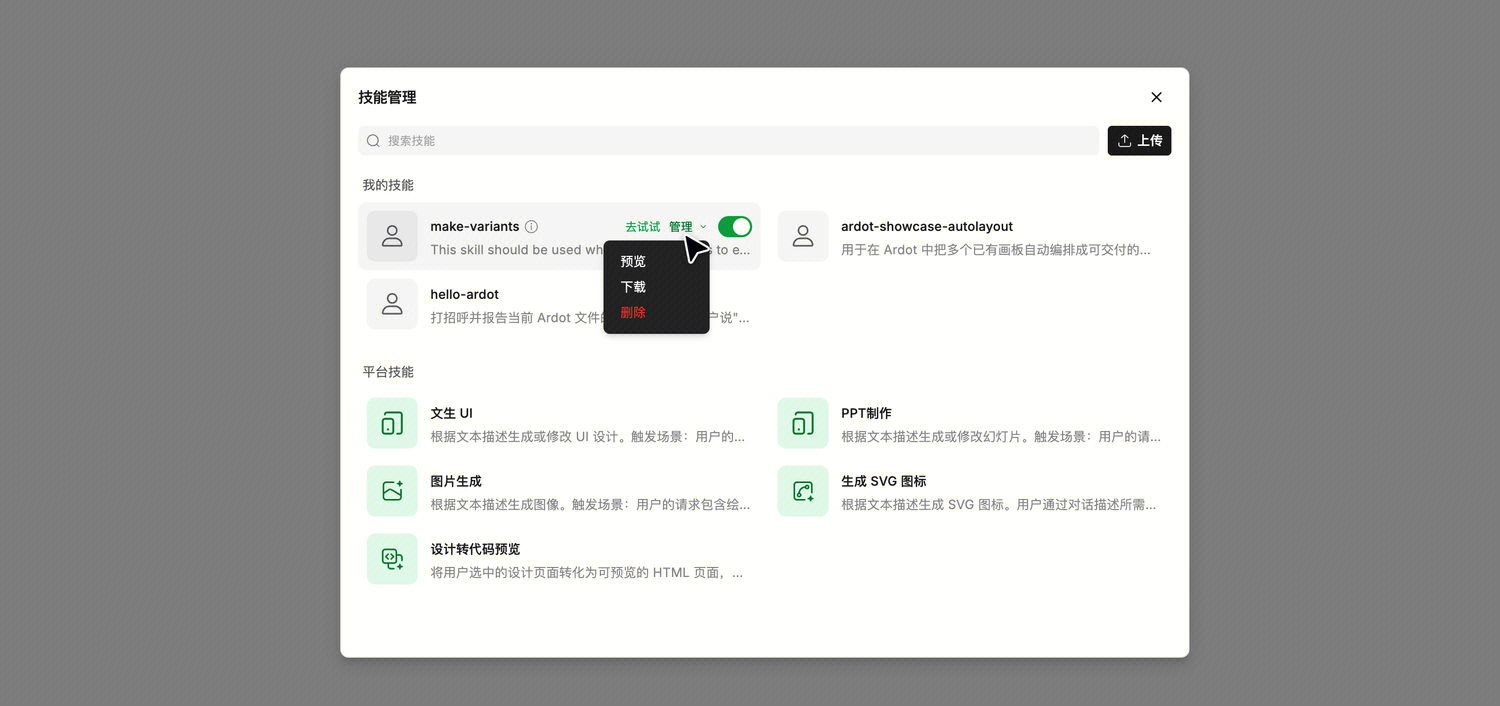
上传 Skill 后,你可以对已有的 Skill 进行管理。
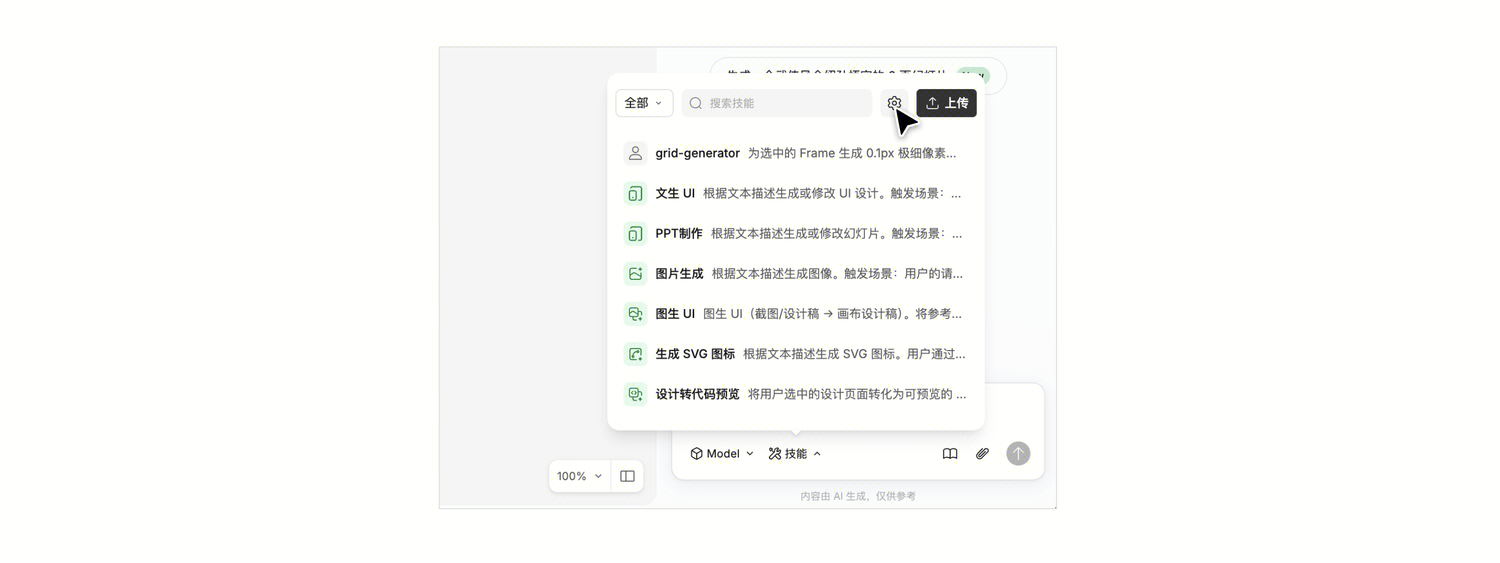
对于用户自己上传的 Skill,可以对其进行预览、下载和删除。如果上传的技能与已有的技能同名,那么就会更新原先上传的同名 Skill。
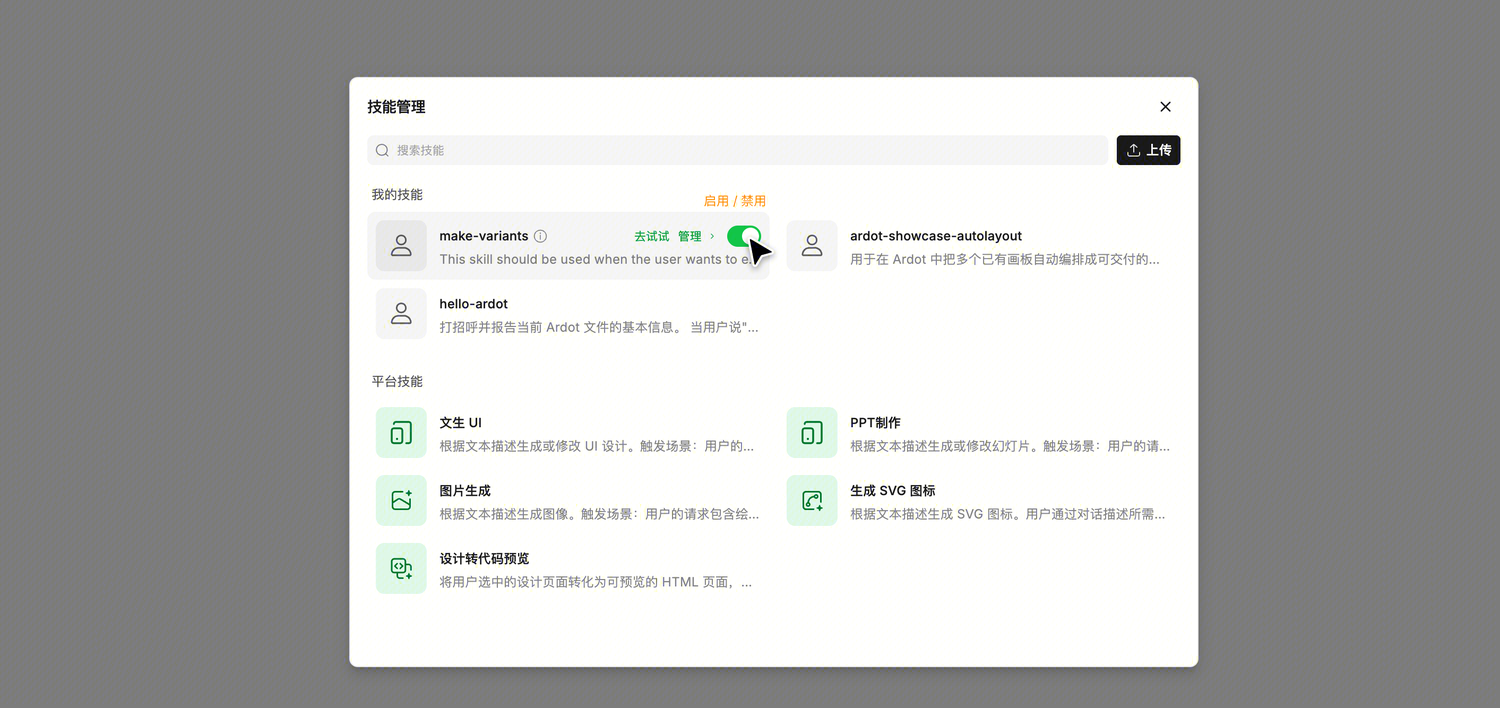
Skill 支持启用和禁用,在明确某些指定 Skill 不需要被使用到的时候,可以将其禁用,模型就无法去调用它。禁用不需要的 Skill 可以保证工作流的纯净稳定以及节省模型 token 消耗。
二、Ardot 客户端运行的关键行为
这一章会重点阐述 Ardot 客户端的几个关键行为,包含加载机制、你能用的工具以及你需要注意的行为约定。阅读这一章可以让你更深入理解 Skill 的运行机制,你也可以把本段内容直接复制给 AI,让它帮助你写出更好的 Skill。
2.1 加载机制
Ardot 客户端的 Skill 加载机制和 Anthropic 规范基本一致,采用按需加载。具体来说:
| 内容 | 启动时是否进 AI 上下文 | 怎么让 AI 看到 |
|---|---|---|
name / description(用于路由) | 是,进入路由层 | 自动 |
| SKILL.md 正文 | 是,Skill 被触发时进入 | 自动 |
references/ 下的文件 | 不会自动加载 | 在 SKILL.md 里告诉 AI 这个文件位置 references/xxx,AI 自己会按需加载 |
assets/ 下的文件 | 不会自动加载 | 同上 |
| Skill 包里没提到的文件 | 不会自动加载 | AI 会根据任务需要主动探索 |
| frontmatter 的其他字段(如 metadata) | 不进执行 AI 的上下文 | 不要在这里写运行时的规则 |
具体到 Ardot ,有几个约束需要留意:
| 维度 | Ardot 的行为 | 写法建议 |
|---|---|---|
| frontmatter | 仅用于路由元数据,执行 AI 看不到 metadata 等字段 | metadata 里只放版本、作者;运行时规则都写到 SKILL.md 正文里 |
| 没提到的文件 | host 不会主动推给 AI,但 AI 可以用 Glob + Read 主动拉取 | 建议在 SKILL.md 里把依赖文件列全,能减少 AI 的探索成本 |
| 子目录递归 | 不会自动扫描 | 引用子目录文件时,路径写完整 |
2.2 你能用到的工具
Ardot MCP 工具(18 个)
完整参数请参考 Ardot MCP 官方文档。这里只列工具名和分类:
| 类别 | 工具 |
|---|---|
| 编辑器状态 | fetch_editor_state、fetch_file_info、batch_read、capture_screenshot、capture_layout |
| 设计系统 | fetch_variables、apply_variables、fetch_component_lib、fetch_guidelines、search_style_guide、build_style_guide |
| 编辑操作 | batch_edit、locate_available_space、create_new_page |
| 资源导出 | scan_exportable_resources、export_nodes、upload_images |
| 辅助 | get_available_fonts |
通用工具
| 工具 | 用途 |
|---|---|
Read、Write、Edit | 文件读写编辑 |
Glob、Grep、Bash | 列目录、搜索内容、跑 shell 命令 |
WebFetch、WebSearch | 网络访问 |
AskUserQuestion | 弹出选项让用户选择(支持单选、多选、自由文本) |
跑脚本
Skill 内可以使用 bash 和 python 跑脚本:
# SKILL.md 里调用脚本的写法
bash scripts/extract.sh
python3 scripts/process.py
需要留意的是:脚本运行时的工作目录是 Skill 包根目录,直接使用相对于 Skill 目录的路径即可。
其他 MCP 服务
除了 Ardot MCP 之外,客户端还内置了几个 MCP 服务,可以按需调用:
| MCP Server | 工具 | 用途 |
|---|---|---|
| frontend_tools | commit_svg_icons、url_to_ui、start_preview_server | 前端开发辅助 |
| svg_tools | search_icon、preview_svg | SVG 资源处理 |
| image_tools | text_to_image、edit_image | 图像生成与编辑 |
2.3 几条需要留意的行为约定
上下文容量
Ardot 客户端使用的 LLM 上下文窗口在 200K tokens 这个量级,长流程不会被截断。
上下文窗口取决于模型
Ardot 实际可用的上下文窗口取决于您选择的模型,各模型规格如下:
| 模型 | 上下文窗口 |
|---|---|
| Claude-Sonnet-4.6 | 1,000,000 tokens(1M) |
| Claude-Opus-4.6 | 1,000,000 tokens(1M) |
| GPT-5.4 | 1,000,000 tokens(1M) |
| GPT-5.3-Codex | 400,000 tokens(400K) |
| Gemini-3.1-Pro | 1,000,000 tokens(1M) |
| Gemini-3.0-Flash | 1,000,000 tokens(1M) |
| Kimi-K2.6 | 256,000 tokens(256K) |
| GLM-5.1 | 204,800 tokens(200K) |
| Deepseek-V4-Pro | 1,000,000 tokens(1M) |
因此,不用过于担心容量问题,但是 SKILL.md 主体还是建议控制在 5000 tokens 以内,详细资料拆到 references/ 里,这是对模型上下文更友好的方式。
references 怎么引用才会被读到
Ardot 客户端不会自动加载 references,所以你需要在 Workflow 步骤里明确告诉 AI 去读,并可以告诉 AI 何时需要读,AI 会在任务需要时主动读取。
弱引用(AI 容易跳过)
## Reference materials
- references/spec.md,执行前请阅读
这种写在末尾备注里的方式,AI 经常会直接开始干活,不会回头来读。
强引用(推荐这么写)
## Workflow

### Step 2 — 计算尺寸

**前置操作**:先用 **Read** 工具读取 `references/sizing-formula.md`,
获取尺寸计算公式。不读公式就开始计算的话,结果会出错。

读完之后按公式计算:
- outerWidth = ...
- outerHeight = ...
把"读 reference"嵌入到 Workflow 步骤里。AI 执行到这一步时就会去读。
把重活落到脚本里
Ardot 支持 scripts 脚本执行,模型不会读取脚本内容而是会直接执行脚本。建议把确定性的计算写成脚本,而不是让模型在上下文里反复推理。
让 LLM 算的方式(耗 token,容易出错)
## Workflow
1. 调 fetch_variables 拿色彩变量
2. 每个颜色把 r/g/b 转 hex:
   - r * 255 四舍五入,转 16 进制,补 0 到 2 位
   - g * 255 ...
   - ...(LLM 每次都要把这套逻辑重新推一遍)
用脚本算(更省 token,更可靠)
## Workflow
1. 调 fetch_variables 拿色彩变量,存到 /tmp/vars.json
2. 调用脚本:
   `python3 scripts/rgba_to_hex.py /tmp/vars.json`
3. 读取脚本输出,得到 hex 列表scripts/rgba_to_hex.py:
import json, sys
data = json.load(open(sys.argv[1]))
for v in data['variables']:
    c = v['color']
    hex = '#{:02X}{:02X}{:02X}'.format(
        round(c['r']*255), round(c['g']*255), round(c['b']*255))
    print(f"{v['name']}: {hex}")
大致的分工原则
- 数据清洗、数值计算、JSON 解析这些适合放脚本
- 业务判断、自然语言生成、决策调度这些交给 LLM
- 脚本路径直接用相对于 Skill 目录的相对路径即可
多步 Skill 的 checkpoint 模板
## Workflow

### Step 1 — 准备阶段
1. 调 fetch_editor_state
2. 把"已完成 Step 1"记录到对话里(方便后续回顾)

### Step 2 — 执行阶段
1. ...
2. 把"已完成 Step 2"记录到对话里

### 用户取消时的处理

如果在任意 Step 收到 rejection 信号:

1. **立即停止后续步骤**
2. 用 **Bash** 清理本步产生的临时文件(如果有的话)
3. **画布上已经成功提交的节点不要清理**(保留用户已有的工作)
4. 向用户报告:
   - 已经完成了哪几个 Step
   - 哪个 Step 被取消了
   - 如果用户重新发起,可以从哪一步继续
四、容易踩的坑以及避坑方法
以下提到的均是我们测试功能过程中遇到的真实问题,也附上了我们建议的解法,希望对大家有所帮助。
| # | 坑 | 后果 | 建议解法 |
|---|---|---|---|
| 1 | 把规则塞进 frontmatter | 执行 AI 完全看不到,等于白写 | 规则全部写到 SKILL.md 正文 |
| 2 | 以为 references 会自动加载 | AI 没读 reference 就开始干活,结果出错 | Workflow 里显式写"用 Read 工具读 references/xxx.md" |
| 3 | SKILL.md 里写"原理"(比如"崩溃日志包含调用栈,记录...") | 浪费 token,对执行没帮助 | 只写步骤,背景信息可以省略 |
| 4 | description 只写"做什么"不写"何时用" | AI 不会主动触发 Skill | 加上 Triggers 关键词,中英文都覆盖 |
| 5 | 写"什么都管"的巨型 Skill | description 边界模糊,AI 不知何时触发 | 拆成小的 Skill,需要时用嵌套调用 |
| 6 | 复制 Skill 改名时忘了改 frontmatter name | validator 报错或加载失败 | name 必须等于父目录名 |
| 7 | 删除、写文件这种破坏性操作直接执行 | 用户感到失控 | 关键破坏性操作前用 AskUserQuestion 确认一下 |
| 8 | AI 训练偏好回退(写了非主流写法,AI 任性改回常见写法) | Skill 行为偏离预期,画布上出现"半像样"的产物 | 三层硬约束:description 写禁令 / 开篇放 ✅❌ 表格 / 操作步骤入口再提醒。配合 batch_read 验证 |
附录 A:常见问题
Q:我的 Skill 上传之后没被触发,怎么排查?
A:多数情况下是 description 没写到位。可以检查:
- description 有没有同时包含"做什么"和"何时用"
- Triggers 有没有覆盖用户实际会说的中英文短语
- name 是否符合命名规范(小写、连字符、等于父目录名)
Q:Skill 跑到一半 AI 自己停下来了,怎么回事?
A:先看一下是不是收到了用户取消(rejection)信号。如果不是,可能是 Step N 失败后 AI 选择停止。建议在 Workflow 里加上 batch_read 校验和明确的错误处理路径。
Q:我从 Figma 移植了一个 Skill,能直接拿过来用吗?
A:直接用是不行的。Figma Skill 调用的是 Figma Plugin API(figma.*、combineAsVariants 等),这些在 Ardot 上没有对应实现。我们正在研究更低成本地帮助大家迁移 Skill 的方法,而在此之前,你可以尝试手动改造:
- 把 Figma API 替换成对应的 Ardot MCP 工具(参考 2.2 节工具集)
- 把 Workflow 改成符合 Ardot MCP 协议的写法
- 在 Ardot 上完整地测试几次
Q:SKILL.md 多长合适?
A:没有硬上限,建议控制在 5000 tokens 以内。超出之后会挤占模型上下文,这也是 Anthropic 社区的普遍共识。详细资料可以拆到 references/ 里。